 執筆: 株式会社AI Orchestra 代表取締役 宮地俊充
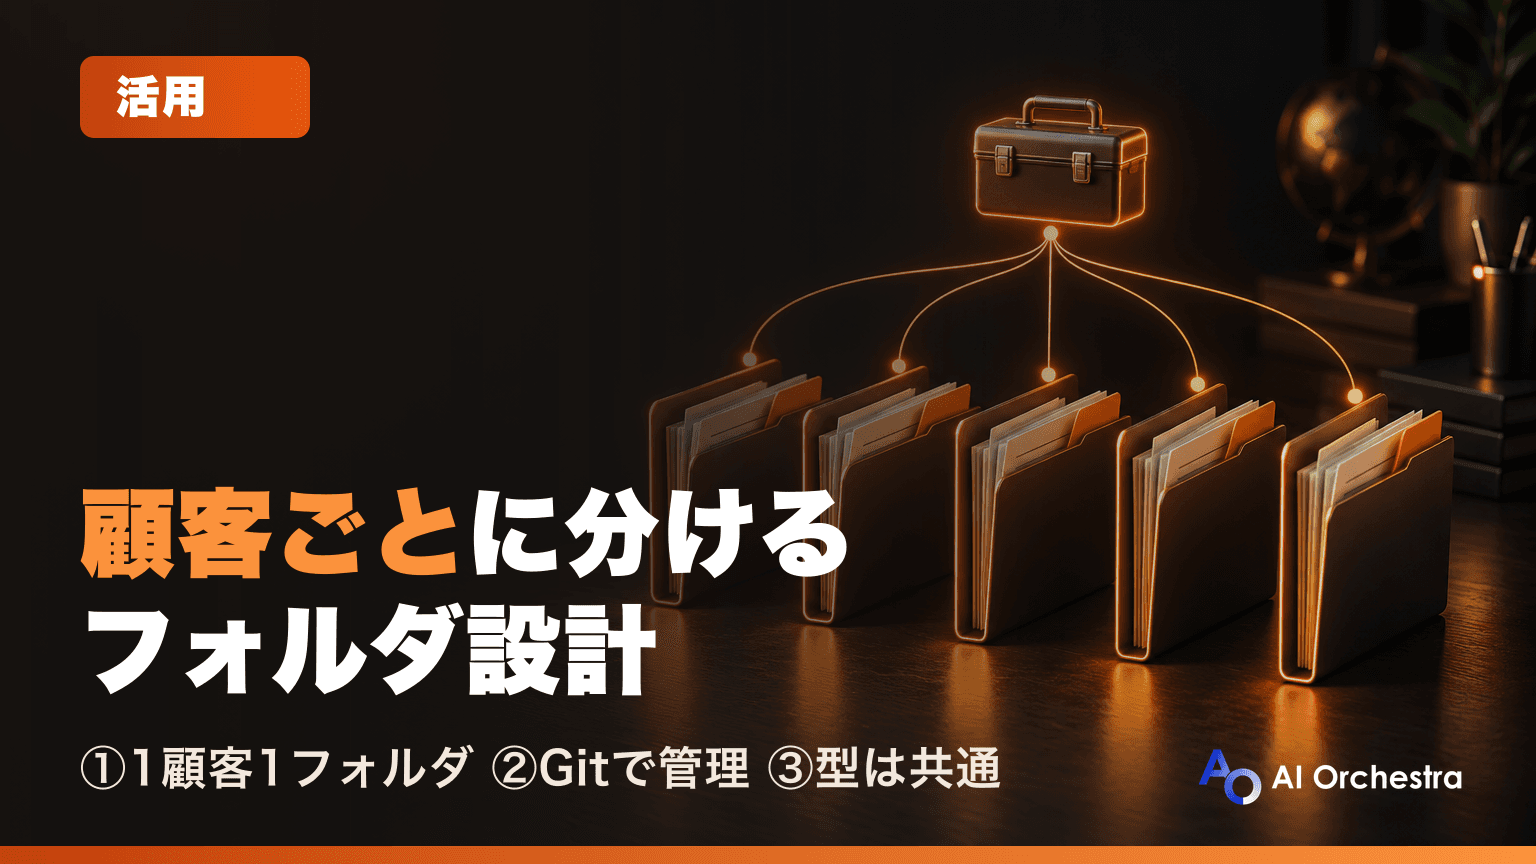
結論 — 顧客ごとにフォルダを分け、Gitリポジトリにする
Claude Codeは、セッションを始めたフォルダを1つの仕事場として動きます。読み込むルール、覚えておく内容、使える権限のどれもが、このフォルダを単位に決まります。
そのため顧客ごとにフォルダを分けると、A社の作業中にB社の前提や資料が入り込まない状態を、特別な設定なしで作れます。分け方そのものが、情報を混ぜないための仕組みになります。
- 11顧客=1フォルダにする — 顧客固有の前提・資料・成果物をその中に閉じる
- 2そのフォルダをGitリポジトリにする — 変更の履歴が残り、Claudeの記憶も顧客単位で分かれる
- 3手順(型)は顧客フォルダの外に1つだけ置く — 全顧客で同じ型を使い、コピーを作らない
プロジェクト機能は「分ける手段」ではない
Claude CodeのProjects(プロジェクト機能)は、関連する作業をクラウドで並行して進めるための司令塔です。顧客の情報を分けて持つ場所ではなく、分けて持った情報の上で作業を回す仕組みと捉えると、役割がはっきりします。
「プロジェクト」と呼ばれるものは3つある
迷いの多くは、「プロジェクト」という言葉が別々のものを指していることから生まれます。Claudeの製品群には、同じ名前で呼ばれるものが3つあります。
表は横にスクロールできます →
| 呼び名 | 正体 | ファイルの扱い | 使えるプラン |
|---|---|---|---|
| Claude Codeの「プロジェクト」(もともとの意味) | セッションを始めたフォルダそのもの | フォルダ内の実ファイルを直接読み書きする | プランを問わない |
| Claude CodeのProjects(プロジェクト機能) | 1つの会話が司令塔になり、タスクごとにクラウドのスレッドを立てて並行で進める仕組み | GitHubリポジトリは複製して使う。手元のファイルはアップロードした写しを読む | ProプランとMaxプランの公開ベータ |
| claude.aiのプロジェクト(チャット・Cowork) | 会話と参照資料をまとめる作業場所 | チャットは資料をアップロードする。Coworkはパソコンのフォルダも指定できる | チャットは無料プランを含む全プラン。Coworkは有料プラン |
アップロードの手間が気になるのは、主に2つ目と3つ目です。アップロードした資料は写しであり、手元のファイルを直しても自動では反映されません。更新のたびに入れ直す必要があります。
claude.aiのプロジェクトは、資料に基づく相談や社内の壁打ちに向いた別の道具です。Teamプランでの使い方は共有プロジェクトの作り方、Coworkとの違いはClaude Coworkとはで解説しています。
フォルダ起点とプロジェクト機能の違い
ここからは、Claude Codeの中での比較に絞ります。フォルダを起点に手元で動かす使い方と、プロジェクト機能でクラウドに任せる使い方は、次のように違います(仕様は公式ドキュメントによる)。
表は横にスクロールできます →
| 比べる点 | フォルダ起点 | プロジェクト機能 |
|---|---|---|
| 動く場所 | 自分のパソコン | 基本はクラウド。タスクごとにスレッドが立ち、並行で進む |
| 情報の正本 | フォルダ内の実ファイルとCLAUDE.md | プロジェクト指示・プロジェクトメモリ・追加したリポジトリとファイル |
| 手元のファイル | そのまま読み書きする | アップロードした写しを読む。更新は入れ直し |
| 使える道具 | そのパソコンの連携・設定・Skillすべて | クラウド環境に用意したものだけ |
| 向く仕事 | 手元の資料や道具が毎回要る仕事 | 関連タスクを次々に渡し、離席中も進めてほしい仕事 |
| 使える場所 | ターミナル・IDE・デスクトップアプリ | Web版・デスクトップアプリ・スマホアプリ |
| 共有 | リポジトリを共有すれば複数人で同じ状態になる | 1人のユーザー専用。他の人と共有できない |
法人で見落としやすいのが提供範囲です。プロジェクト機能は公開ベータで、対象はProプランとMaxプランです。TeamプランとEnterpriseプランではまだ使えません。会社で契約している場合は、フォルダ起点が選択肢になります。
手元のフォルダを追加した場合の上限もあります。取り込まれるのは先頭100ファイル・合計200MBまでで、30MBを超えるファイルと隠しファイルは除かれます。追加できるフォルダは1プロジェクトで10個までです。
GitHubリポジトリならアップロードは要らない
プロジェクト機能でも、GitHubリポジトリは追加するだけで各スレッドが複製して使います。リポジトリの中のCLAUDE.mdとSkillも読み込まれます。アップロードが必要になるのは、Gitで管理していないファイルだけです。
フォルダを分けるだけで顧客が混ざらなくなる理由
フォルダを分けるだけで足りる理由は、Claude Codeの仕組みにあります。ルール・記憶・権限の3つが、どれもフォルダを単位に切り替わるからです。
- ルール(CLAUDE.md) — セッションを始めたフォルダと、その上の階層にあるCLAUDE.mdが起動時に読まれる。顧客フォルダに置いた前提は、その顧客の作業のときだけ効く
- 記憶(auto memory) — Claudeが自分で書き溜めるメモは、Gitリポジトリごとに別の場所へ保存される。リポジトリの外では、始めたフォルダが単位になる
- 権限と設定 — 確認なしで読めるのは始めたフォルダの中。許可ルールやSkillもフォルダごとに持てる
この中で最も見落とされやすいのが記憶の単位です。1つのリポジトリの中に全顧客のサブフォルダを並べると、どの顧客の作業で得た気づきも同じ場所に溜まります。A社で覚えたことが、B社の作業に持ち込まれる構造です。
顧客ごとにリポジトリを分けておけば、記憶も顧客ごとに自然に分かれます。仕組みの詳細はClaude Codeのメモリ機能にまとめています。
フォルダの外を読ませたくない場合は、設定で縛ることもできます。作業フォルダの外の読み取りを拒否する設定があり、顧客情報を扱う現場では有効です。権限の考え方は権限設定の完全ガイドをご覧ください。
顧客フォルダの構成例 — 型は共通、中身は顧客ごと
中身の構成は、凝る必要はありません。全顧客で同じ並びにしておくことのほうが大切です。並びが同じなら、同じ指示・同じ手順がどの顧客でもそのまま通ります。
顧客別/
├── a-sha/                 ← A社(ここでセッションを始める)
│   ├── CLAUDE.md          この顧客の前提・禁止事項・正本の場所
│   ├── 01_基本情報/        契約内容・担当者・業務の範囲
│   ├── 02_受領資料/        顧客から届いた原本(上書きしない)
│   ├── 03_作業中/          加工途中のファイル
│   ├── 04_成果物/          納品したもの
│   └── 05_記録/            打ち合わせの記録・判断の経緯
├── b-sha/                 ← B社(同じ並び)
└── c-sha/

共通の手順(型)は顧客フォルダの外に置く
~/.claude/skills/ 月次レポート・議事録整形などのSkill顧客フォルダのCLAUDE.mdに書くのは、その顧客にしか当てはまらないことだけです。契約上の制約、使ってはいけない表現、資料の正本がどこにあるか。書き方はCLAUDE.mdの書き方を参考にしてください。
一方、月次レポートの作り方や議事録の整え方のような手順は、顧客が変わっても同じです。型は顧客フォルダの外に1つだけ置き、全顧客から同じものを使います。自分用ならユーザーレベルのSkill、チームに配るならプラグインが置き場所になります。
何をどこに置くかの全体像はClaude Codeのナレッジ管理で整理しています。顧客フォルダは業務データの置き場、Skillやプラグインは型の置き場と分けて考えると迷いません。
なぜGitリポジトリにするのか
フォルダを分けるだけでも効果はありますが、もう一歩進めてGitリポジトリにすることをおすすめします。エンジニアのための道具に見えますが、顧客の仕事を預かる立場にこそ利点があります。
- 1変更の履歴が残る — いつ・何を・どう書き換えたかを追え、Claudeが広い範囲を書き換えたあとでも前の状態へ戻せる
- 2記憶が顧客単位で分かれる — auto memoryはリポジトリごとに保存されるため、顧客をまたいだ混入が起きにくい
- 3複数人・複数端末で同じ状態になる — 担当者が替わっても、リポジトリを取得すれば前提と経緯がそのまま届く
- 4クラウドでの実行にそのまま載る — クラウドセッションやプロジェクト機能は、GitHubリポジトリを複製して動く。資料の入れ直しが要らない
Gitを触ったことがなくても始められます。Claude Codeに「このフォルダをGitで管理して」と頼めば、初期化から最初の記録まで進めてくれます。日々の記録も「ここまでを保存して」と伝えるだけで構いません。
Gitで管理することと、外部に置くことは別
Gitの履歴管理は、自分のパソコンの中だけでも使えます。GitHubに置く場合は必ず非公開リポジトリにし、顧客との契約や社内規程で外部サービスに置けない資料は、リポジトリに含めない設定にしてください。入力データの扱いは学習させない設定もあわせてご確認ください。
作業ディレクトリの運用 — 顧客の切り替えは新しいセッションで
フォルダを分けたら、あとはその顧客のフォルダでセッションを始めるだけです。デスクトップアプリなら開始時にフォルダを選び、ターミナルならそのフォルダへ移動してから起動します。
- 顧客を切り替えるとき — 新しいセッションをその顧客のフォルダで始める。途中で作業フォルダを移す
/cdもあるが、会話の内容は引き継がれるため、顧客をまたぐ用途には使わない - 別のフォルダも参照したいとき —
/add-dirで追加する。共通の資料置き場を読ませる場面に向く - 特定のファイルを指定したいとき — 入力欄で
@に続けてファイル名を入力する。フォルダの中から候補が出る
複数の顧客を横断して集計したい場面もあります。その場合だけ、親フォルダでセッションを始めるか、必要な顧客フォルダを明示的に追加します。普段の作業を親フォルダで行わないことが、取り違えを防ぐ基本です。
前回の続きから再開する方法はセッション再開ガイドにまとめています。セッションの履歴はフォルダごとに並ぶため、顧客フォルダで開けば、その顧客の作業だけを探せます。
プロジェクト機能が向く場面
プロジェクト機能が力を発揮するのは、1つの顧客について関連する作業が次々に発生し、並行して進めたいときです。会話にタスクを渡すと、Claudeがタスクごとにスレッドを立てて進めます。
- 離席中も進めてほしい — クラウドのスレッドはパソコンを閉じても動き続ける
- スマホから様子を見て指示したい — スマホアプリから進み具合を確かめ、返事を返せる
- 前提を毎回説明したくない — プロジェクト指示に書いた決まりが、新しいスレッドすべてに届く
ただし、自分のパソコンで始めたセッションはプロジェクトに入れられません。手元の資料や連携が毎回必要な仕事は、フォルダ起点のままが向いています。プランの利用枠も、通常のセッションより速く消費します。
順番としては、まず顧客ごとのリポジトリを作り、必要になったらそのリポジトリをプロジェクトに追加します。土台ができていれば、あとから載せるのは追加の操作だけで済みます。
クラウドで動かす使い方の全体像は、アプリ・Web版・スマホ対応のまとめをご覧ください。手元で動かすか、クラウドに任せるかを選ぶ前提として役立ちます。
AI Orchestraの運用 — 型を1つ直せば全案件に効く
当社でも、事業や案件ごとにリポジトリを分けて運用しています。共通のSkillとルールは共有用のリポジトリ1つに置き、各リポジトリからは参照するだけにしています。
この形にしてよかったのは、型を1つ直すと、すべての案件の作業が同時に良くなることです。顧客が10社あっても、調べ方や分析の進め方は共通です。分けるのは情報で、手順は分けません。
決まりは1つだけで、同じものを複数の場所へコピーしないことです。コピーを置くと、片方だけが更新されて食い違います。顧客別の管理は、分けることと同じくらい「共通のものを1つに保つこと」が効いてきます。
よくある3つの失敗
顧客別の管理でよく見かける失敗は、次の3つです。どれも最初の分け方で防げます。
- 11つの大きなフォルダに全顧客を入れる — ルールが肥大し、記憶が混ざり、似た名前の資料を取り違える。分けるのは後になるほど手間が増える
- 2顧客フォルダごとに手順をコピーする — 1か所を直しても他に反映されず、顧客ごとに少しずつ違う版が残る。型は1つにして参照する
- 3アップロードした写しを正本だと思い込む — 手元で直した内容が反映されないまま、古い資料をもとに作業が進む。正本はフォルダ側に置く
研修・導入支援では、フォルダ設計から一緒に決めます
顧客別の管理でつまずくのは、機能の理解よりも自社の業務をどの単位で切るかが決まらないことです。顧客単位か、案件単位か、年度で分けるか。答えは業務の流れによって変わります。
たとえばリード社会保険労務士法人様の導入検証事例では、帳票を読み取り、命名規則に沿ってフォルダを作って整理する作業をClaude Codeで検証しました。フォルダの決まりが明確なほど、任せられる範囲は広がります。
AI OrchestraのClaude Code研修・導入支援では、フォルダとリポジトリの設計から、CLAUDE.md・Skillの整備、チームへの配り方まで伴走しています。顧客が増えても回る形を最初に作っておきたい企業様は、お気軽にご相談ください。
Claude Codeを組織に定着させたい企業様へ。AI Orchestraの法人研修・導入支援をご覧ください。